tunsrc を設定しても Linux の SRv6 H.Encaps.L2 が遅かったのはなぜか
※ この記事の文章は Claude に書かせ、筆者が確認・修正したものです。
前回の記事では、tunsrc を設定すると H.Encaps.V6 も H.Encaps.L2 も速くなりました。それでも H.Encaps.L2 は 660.7 kpps で、H.Encaps.V6 の 976.4 kpps には届いていませんでした(どちらも tunsrc を設定したときの PDR)。同じ入力パケットに対して H.Encaps.L2 が余分に載せるのは内側の 14 バイトの Ethernet ヘッダで、それだけでスループットが 3 分の 1 も落ちるはずはありません。調べてみると、原因はパケット毎の不要なメモリ確保で、修正はすでに net-next に入っています。
測定環境
以下はすべて、修正の直前と修正を含む net-next を同じ設定(Ubuntu の設定をもとにしたもので、CONFIG_INIT_ON_ALLOC_DEFAULT_ON=y)でビルドして測りました。SUT(測定対象のマシン)の CPU は Xeon E5-2650 v3(2.30 GHz)で、64 バイトのフレームを 1 コアで転送します。T-Rex を動かす tester とは Intel 82599ES(ixgbe)で直結しています。IOMMU は passthrough(iommu=pt)で、tunsrc は設定済みです。スループットは前回と同じく、Ubuntu 24.04 と Python 3.12 で動くように直した SRPerf のフォークで測っています。指標は PDR(Partial Drop Rate、パケットロス率 0.5% 以下で転送できる最大の送信レート)と MRR(Maximum Receive Rate、回線速度いっぱいで送ったときの受信レート)の 2 つです。
flame graph に出ていたもの
修正前のカーネルでもロスなく転送できる 500 kpps 固定で H.Encaps.L2 のトラフィックを流し、転送しているコアの flame graph を取りました。
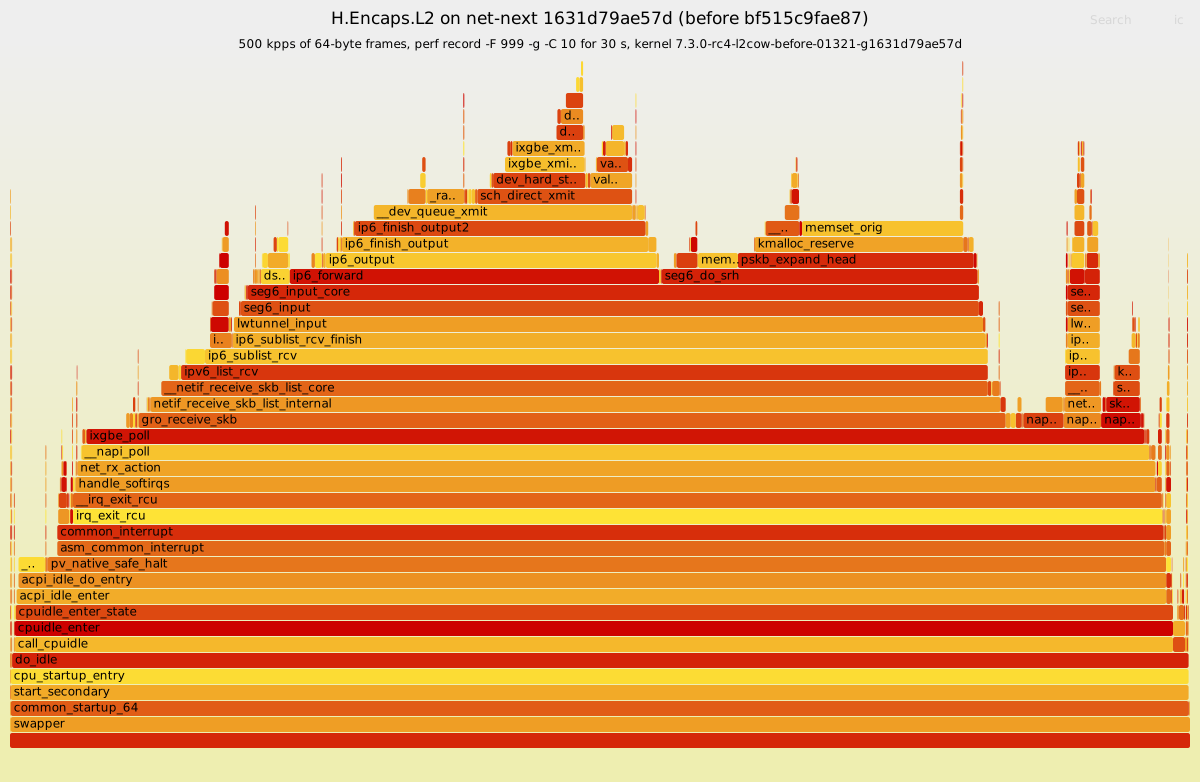
呼び出し先を含めると、サンプルされたサイクルのうち pskb_expand_head() が 21.1%、kmalloc_reserve() が 18.7%、memset_orig() が 14.1% を占めています。memset_orig() のサンプルはすべて seg6_do_srh() → pskb_expand_head() → kmalloc_reserve() の経路にあるので、このゼロ埋めは skb の head を確保し直す処理から来ています。これがパケット毎に起きていることは、コードを見るとわかります。
なぜパケット毎に skb の head を確保し直していたのか
net/ipv6/seg6_iptunnel.c の seg6_do_srh() は、外側の IPv6 ヘッダを作る前に Ethernet ヘッダをパケットの先頭に戻します。L2 の encap モードでは、その場所を空けるために pskb_expand_head() を無条件に呼んでいました。pskb_expand_head() は、既存の headroom が足りていても、必ず新しい head を確保して headroom と linear 部分のデータをコピーします。IPv6 の encap モードは代わりに skb_cow_head() を使っていて、こちらは headroom が足りないときか、skb が clone されていてヘッダ部分を共有しているときだけ確保し直します。
この環境では、skb は 206 バイトの headroom を持って seg6_do_srh() に届きます。一方、segment が 1 つの L2 encap に必要なのは 94 バイト(Ethernet ヘッダ 14、IPv6 ヘッダ 40、SRH 24、送信側のリンク層ヘッダ用に確保する 16)です。skb は clone もされていなかったので、確保し直す必要はありませんでした。
このコストを大きくしていたのが CONFIG_INIT_ON_ALLOC_DEFAULT_ON です。これは Linux 5.3 で入ったセキュリティ強化のためのオプションで、ページと slab の確保時にメモリをゼロ埋めして、古いデータが見えてしまう危険を減らします。Ubuntu と Debian ではデフォルトで有効で、今回のカーネルでも有効だったため、確保し直した head も毎回 memset() でゼロ埋めされていました。init_on_alloc=0 で無効にもできますが、性能のためにセキュリティ機能を切るのは本末転倒です。
無条件の確保し直しは 2017 年に H.Encaps.L2 が追加されたときからあるので、SRPerf の論文で使われたカーネル(5.2 の開発期間中の net-next)にもありました。ただし、そのカーネルは 5.3 で入った init_on_alloc より前のもので、論文では H.Encaps.L2 は H.Encaps.V6 にずっと近い値でした(約 828 kpps と 978 kpps で、0.85)。差のうちどれだけがゼロ埋めによるものかを見るために、修正前のカーネルを init_on_alloc=0 で起動して測りました。
| init_on_alloc | H.Encaps.V6 | H.Encaps.L2 | L2/V6 |
|---|---|---|---|
| 1(デフォルト) | 937.7 | 644.0 | 0.69 |
| 0 | 938.0 | 773.9 | 0.83 |
(MRR、単位は kpps、10 回の平均、修正前のカーネル)
ゼロ埋めがなくなると L2/V6 は 0.69 から 0.83 になり、論文の値に近づきます。
修正内容
修正では、encap 全体に必要な分を最初に skb_cow_head() に要求します。
-		if (pskb_expand_head(skb, skb->mac_len, 0, GFP_ATOMIC) < 0)
-			return -ENOMEM;
+		headroom = skb->mac_len + sizeof(struct ipv6hdr) +
+			   ipv6_optlen(tinfo->srh) +
+			   dst_dev_overhead(cache_dst, skb);
+
+		err = skb_cow_head(skb, headroom);
+		if (unlikely(err))
+			return err;
headroom が足りていて skb が clone されていなければ、何も確保し直しません。本当に headroom が足りないときは head を 1 回だけ確保し直し、その後の IPv6 encap のコードにある skb_cow_head() の時点では必要な空きがすでにあるので、2 回目の確保し直しは起きません。
修正後は、同じ負荷で取った flame graph から確保の処理が消えました。
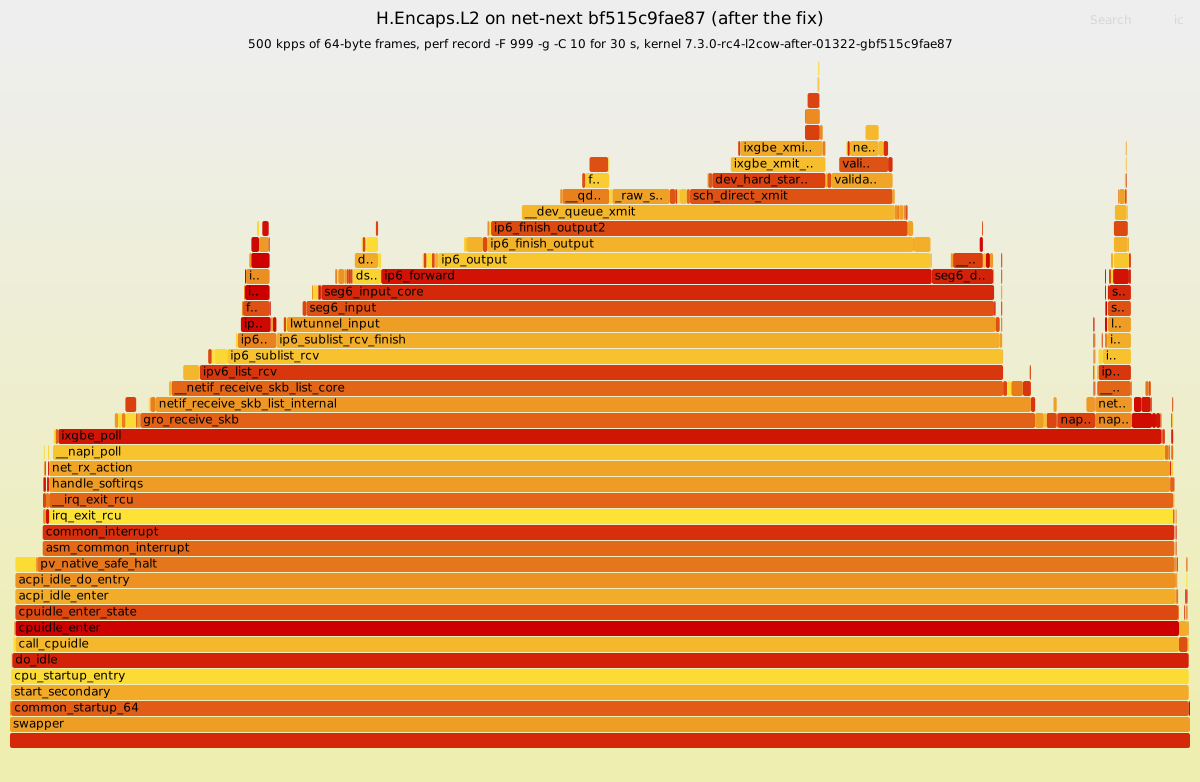
pskb_expand_head()、kmalloc_reserve()、memset_orig() のサンプルはなくなり、seg6_do_srh() は 28.2% から 5.6% に下がりました。修正前後で 30 秒ずつ取ったサイクル数を、その間に転送した 1500 万パケットで割ると、1 パケットあたり 3862 サイクルだったのが 2602 サイクルになっています。
測定結果
| H.Encaps.L2 の PDR | |
|---|---|
| 修正前 | 654.6 kpps |
| 修正後 | 965.7 kpps(+47.5%) |
(10 秒の試行で PDR を探索するのを 10 回繰り返した平均)
H.Encaps.V6 はこのコードを通らないので、MRR はどちらのカーネルでも約 938 kpps のままです。修正後のカーネルを init_on_alloc=0 で起動すると L2/V6 は 1.02(MRR で 956.8 kpps と 939.1 kpps)で、H.Encaps.L2 は H.Encaps.V6 と同じ速さになりました。ゼロ埋めをなくしても残っていた差は、確保し直しそのものによるものだったことになります。
upstream に入るまで
最初のバージョン(v1)では、skb_cow_head() に skb->mac_len だけを要求していました。これでは、clone されてヘッダ部分を共有している skb の場合、共有をやめるときと外側のヘッダを付けるときの 2 回 head を確保し直すことがあると Eric Dumazet に指摘され、v2 では上のように encap 全体の分を要求するようにしました。
v2 のレビュー中に、netdev の AI レビューボットである Sashiko が別のバグを見つけました。dst_dev_overhead() は送信側デバイスのリンク層ヘッダの分の空きを確保しますが、コードがパケットの先頭に作り直すのは受信側の MAC ヘッダです。受信側の MAC ヘッダのほうが長いとき(例えば reorder_hdr off で VLAN タグ付きのフレームを受けたとき)は、作り直すヘッダの offset が回り込み、コピー先がバッファの約 64 KB 先になります。これは L2 モードに限った問題ではないので、dst_dev_overhead() 側で別に直して net ツリーに送りました。そちらが先にマージされ、その後このパッチの v3 が net-next に入りました。net-next は現在 7.3-rc をもとに開発されているので、Linux 7.4 に入る見込みです。
参考文献
- seg6: reallocate the skb head on L2 encapsulation only when needed(net-next、bf515c9fae87)
- net: ipv6: keep room for the mac header in dst_dev_overhead()(net、87cd6b717e40)
- パッチのスレッド: v1、v3
- A. Abdelsalam, P. L. Ventre, C. Scarpitta, A. Mayer, S. Salsano, P. Camarillo, F. Clad, C. Filsfils, “SRPerf: A Performance Evaluation Framework for IPv6 Segment Routing”, IEEE Transactions on Network and Service Management, vol. 18, no. 2, pp. 2320-2333, 2021
- The kernel’s command-line parameters: init_on_alloc
- SRPerf(GitHub)とフォーク
- Linux の SRv6 H.Encaps は tunsrc を設定しないとどの程度性能が落ちるのか
- Brendan Gregg の FlameGraph